数值不能只靠试玩感觉
人和 AI 一起做游戏 · 第 10 篇
本篇依据截至 2026 年 8 月 2 日的开发记录,回顾 2026 年 6—7 月及 8 月初的开发过程。正文中的“当前”、数值、画面、候选资源与验证结论均指当时快照,不代表现售版本的状态。
动画、背景和特效进入游戏以后,画面上的问题通常很直观:动作断了、图层错了、特效位置不对,都能直接看见。数值问题却经常伪装成一句含糊的评价——“这一关好像有点难”。
开发者亲自玩《Kibble Street TD》时,已经熟悉单位克制、出兵节奏和升级顺序。同一关顺利通过,可能只是这一局的选择和随机变化刚好有利;连续失败,也可能只是操作偏差。一次试玩可以发现可疑位置,却不能证明整个关卡曲线是否健康。
因此数值调整的起点不是立刻把敌人血量降低 10%,而是先把“难”拆成可以测量的问题:胜率是多少,胜利需要多久,失败发生在什么时刻,玩家基地还剩多少生命,进入这一关前负担得起什么升级,以及连续推进时要重复失败多少次。
一局结果只是一个样本
这次用当前配置测试第 8 关时,固定普通操作模型、推荐区间中部的升级等级,不使用临时道具,对同一关运行了 100 次模拟。结果是 37 次胜利、63 次失败;胜利样本的中位时长为 277.7 秒,而这一关设定的目标区间是 125~200 秒。
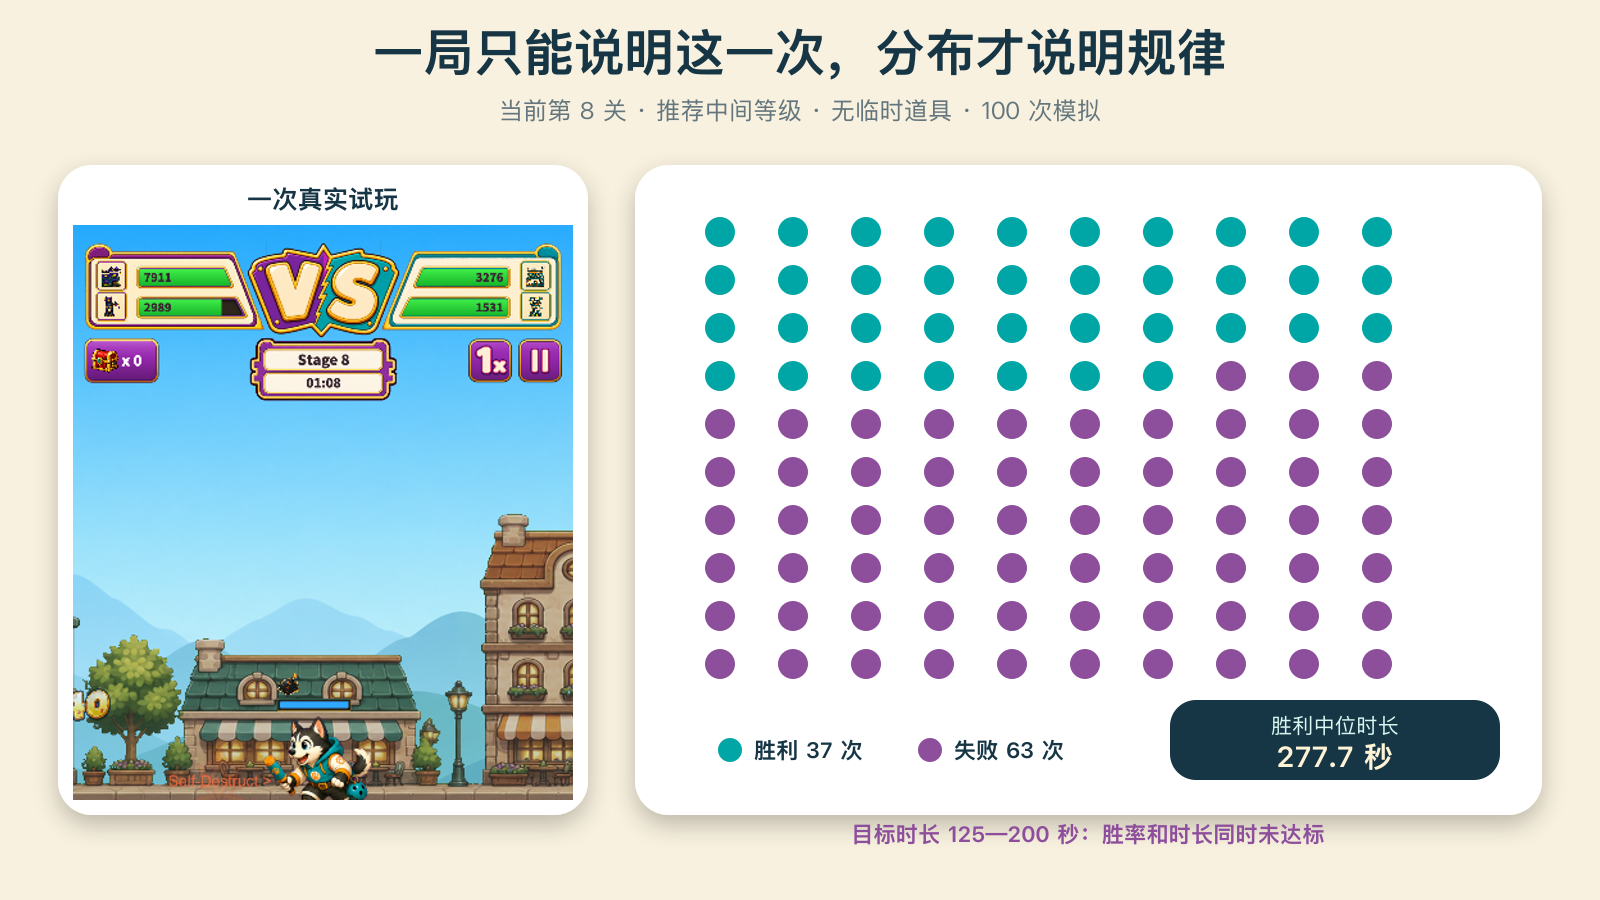
如果只试玩到那 37 次胜利中的一次,结论很可能是“能过,只是稍微慢一点”;如果只撞上一次快速失败,又可能把问题误判成敌方攻击太高。100 次结果放在一起后,才看得到两个同时存在的问题:胜率偏低,而且成功的局也明显过长。
批量模拟并不比真人更懂好不好玩。它的价值是保持条件一致,把重复试验做完,并告诉人问题更像偶然还是规律。最终目标仍由人决定:第 8 关应该让多少普通玩家首次通过,多长的战斗开始让人疲劳,失败多少次以后升级提示才有意义。
先把奖励、升级和下一关连成闭环
战斗数值不能只看敌我血量。玩家在一局结束后拿到多少 KIBBLE,能买到哪一级升级,又会带着怎样的强度进入下一关,这些共同决定了实际难度。
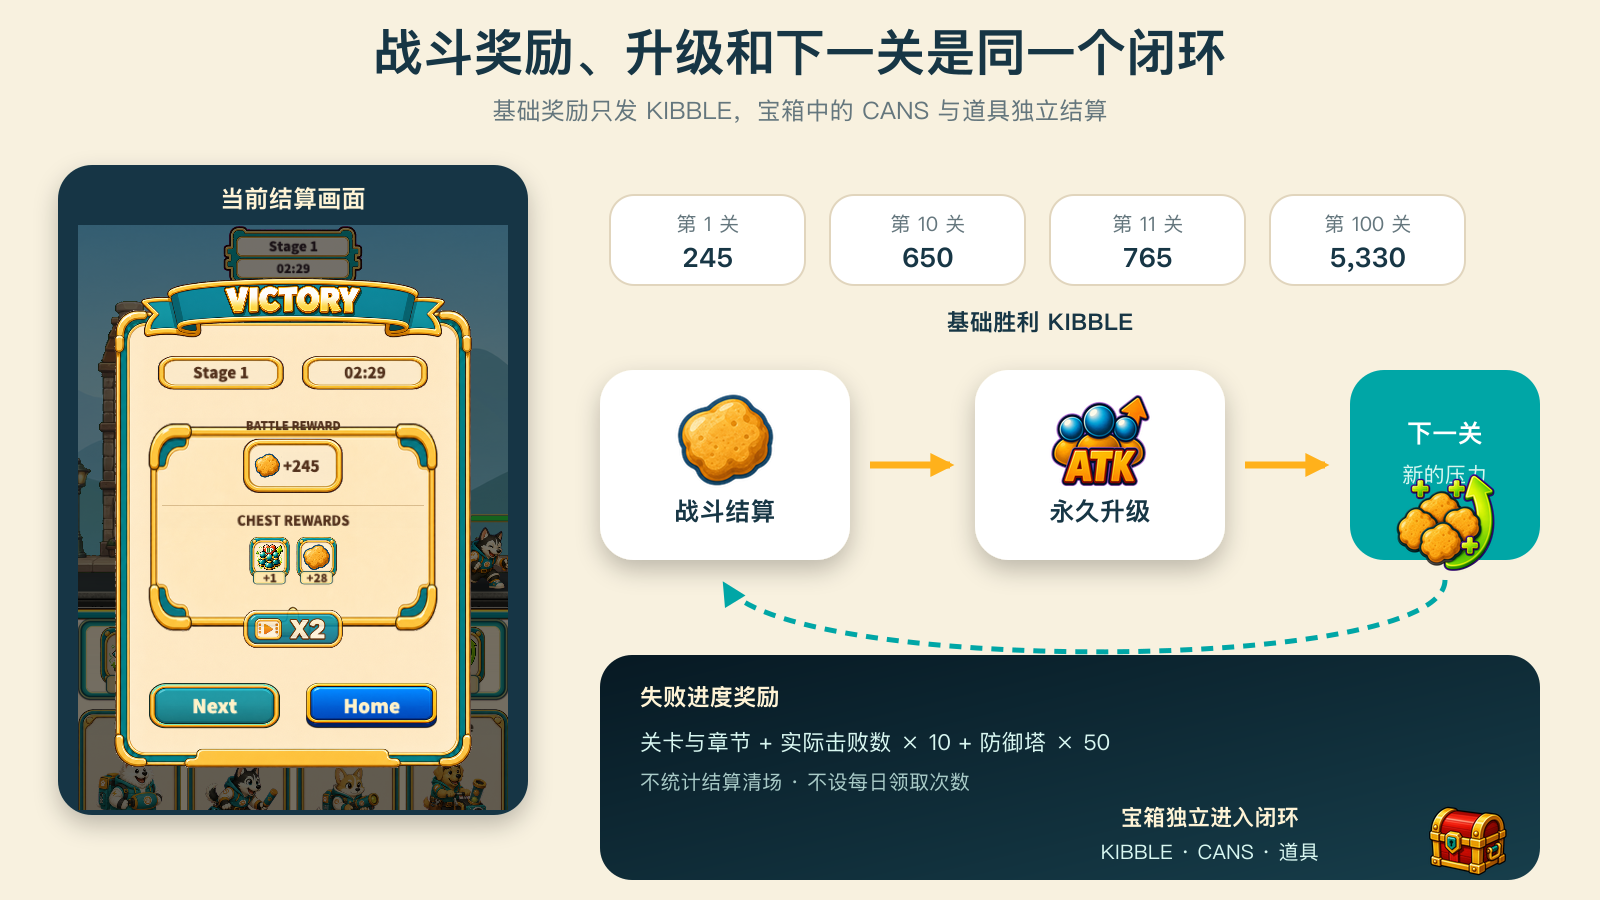
当前基础胜利奖励由关卡和章节共同决定:第 1 关是 245 KIBBLE,第 10 关是 650,第 11 关因为进入下一章节变成 765,第 100 关是 5330。基础胜利奖励只发 KIBBLE;CANS 和道具留在宝箱、广告及商店等独立来源中,不把多种货币混进同一条关卡公式。
失败也不是固定发一个安慰数字。结算会统计实际击败的敌方单位和是否摧毁敌方防御塔,再加上关卡与章节进度。每击败一个敌方单位增加 10 KIBBLE,摧毁敌方防御塔再增加 50;结算后的清场不计入,失败奖励也不设置每日领取次数。
这样设计的目的不是鼓励反复失败,而是避免玩家已经推进到最后一段,却因为没有任何收入而永远停在升级门槛之前。奖励过少会形成死锁,奖励过多又会让失败成为更高效的刷取方式,两边都需要结合连续关卡模拟检查。
升级价格不是一条随手画出的直线
《Kibble Street TD》当前有九条升级轨,不同属性使用不同成本倍率。价格先由基础值、等级的一次项、二次项和三次项组成,从购买第 11 级起,再在原曲线上按当前等级增加后段增幅。
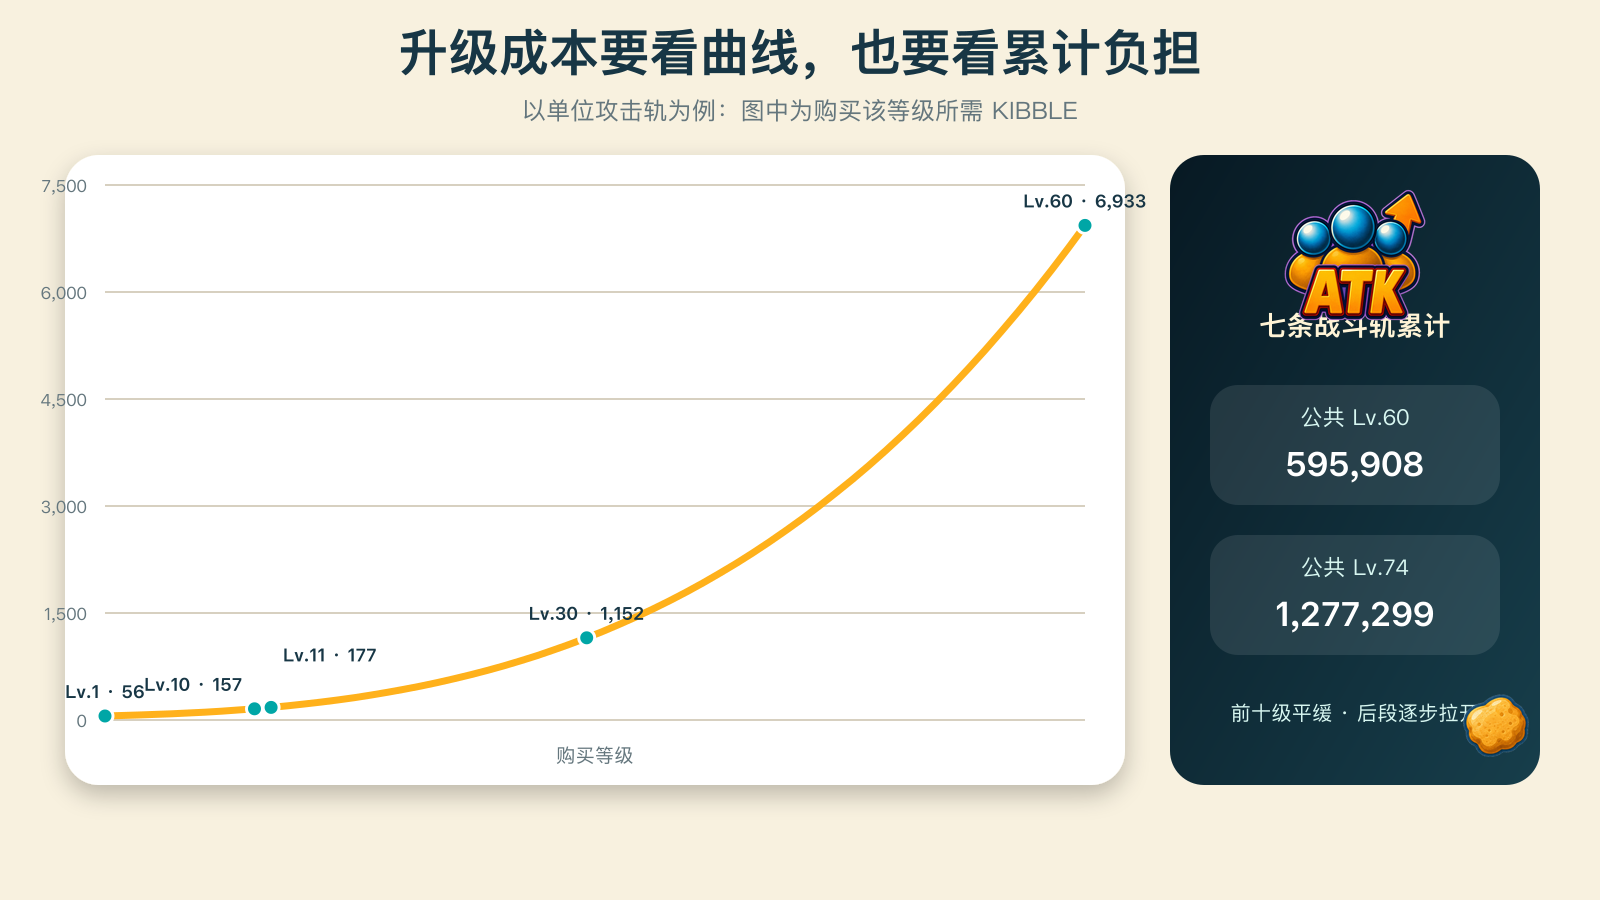
前十级保持较平缓,是为了让玩家尽快理解“战斗获得资源、资源改善下一场战斗”的关系。等级继续上升后,单级价格逐渐拉开,避免长期成长变成没有选择的连续点击。七条基础战斗轨全部升到公共等级 60,累计需要 595,908 KIBBLE;升到 74,累计达到 1,277,299。
只看某一级价格,很难判断曲线是否合理。真正需要比较的是一段时间内的总收入、升级顺序和累计支出:玩家通关得到的钱是否足以支撑推荐等级,失败奖励能否缩短卡关,又会不会让经济增长快到失去取舍。
敌人强度必须有唯一的压力来源
如果单位生命、单位攻击、防御塔、基地和出兵节奏各自拥有一套关卡倍率,某次调整很容易在另一个位置被重复放大。项目现在只用两条压力锚点描述敌方数值:每秒需要处理的总生命,以及每秒计划投放的理论伤害能力。
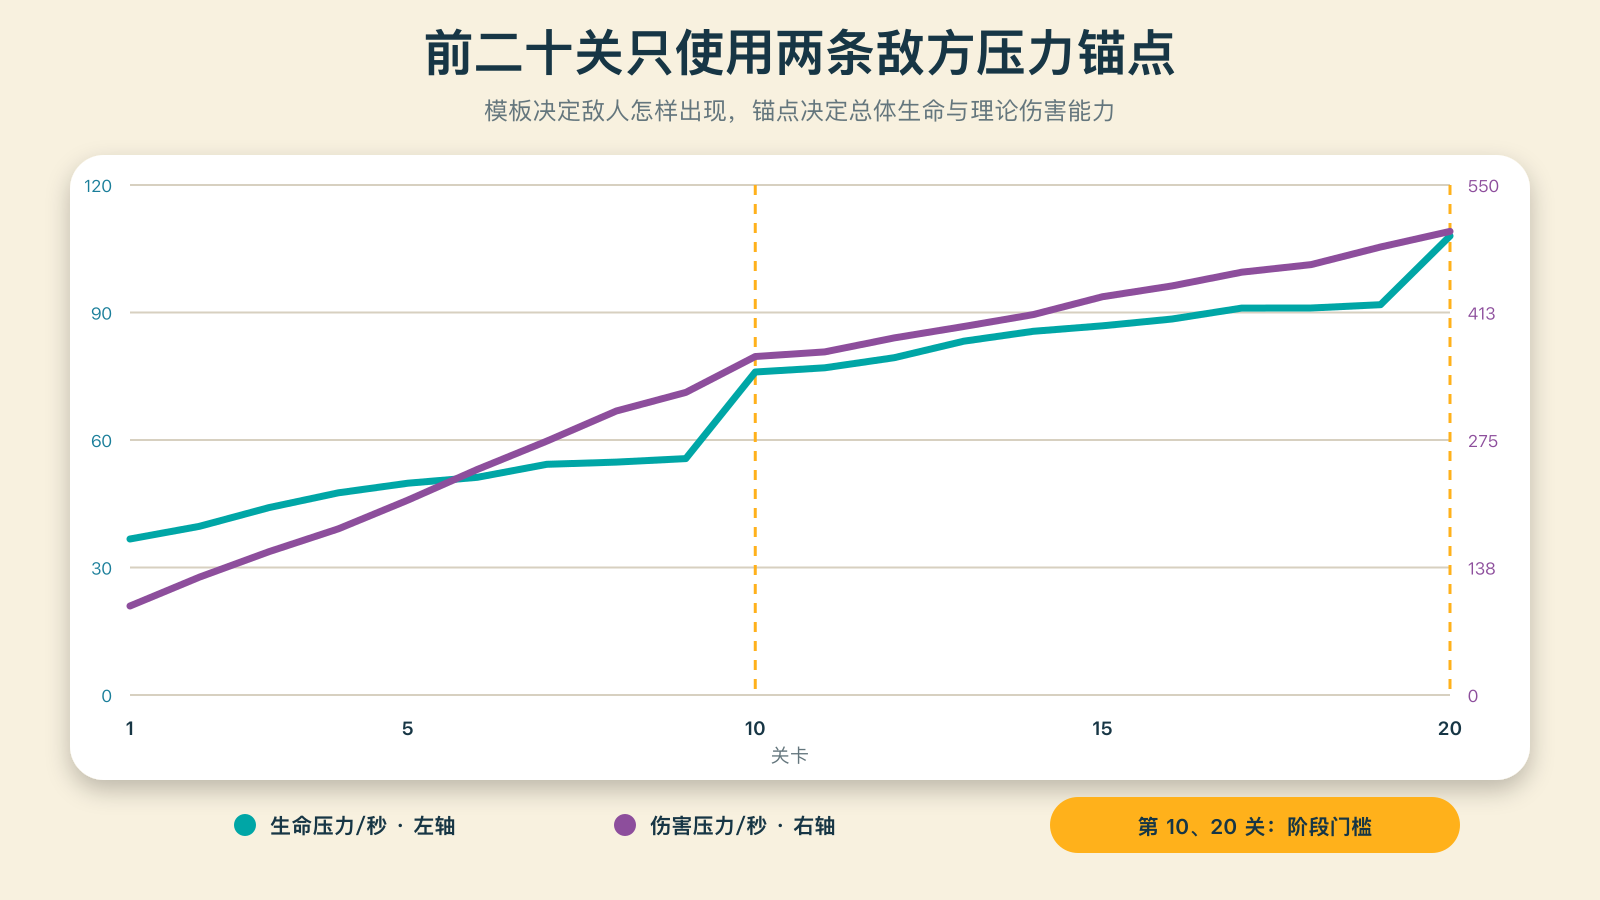
关卡模板仍然负责敌人种类、数量、出场时间和机制事件,压力锚点负责把这套模板反算成最终生命与攻击缩放。相邻锚点之间按关卡线性插值,运行时不再叠加一组看不见的额外难度倍率。
图中可以看到第 10 关和第 20 关的阶段性抬升。它们不是单纯把所有敌人变厚,而是和 Boss 时间轴一起构成阶段门槛。修改模板之后还要重新计算压力,因为同样的目标值遇到不同兵种和出场时间,实际战斗峰值并不相同。
同一关要用不同升级投入重复测
为避免“给玩家多升几级就好了”的简单结论,同一关会分别使用最低推荐、中间推荐和最高推荐等级运行。当前无临时道具的 100 次模拟显示,第 9 关从最低推荐的 21% 胜率,提高到最高推荐的 86%,胜利中位时长也从 281.7 秒降到 159.4 秒,说明升级投入确实能解决主要压力。
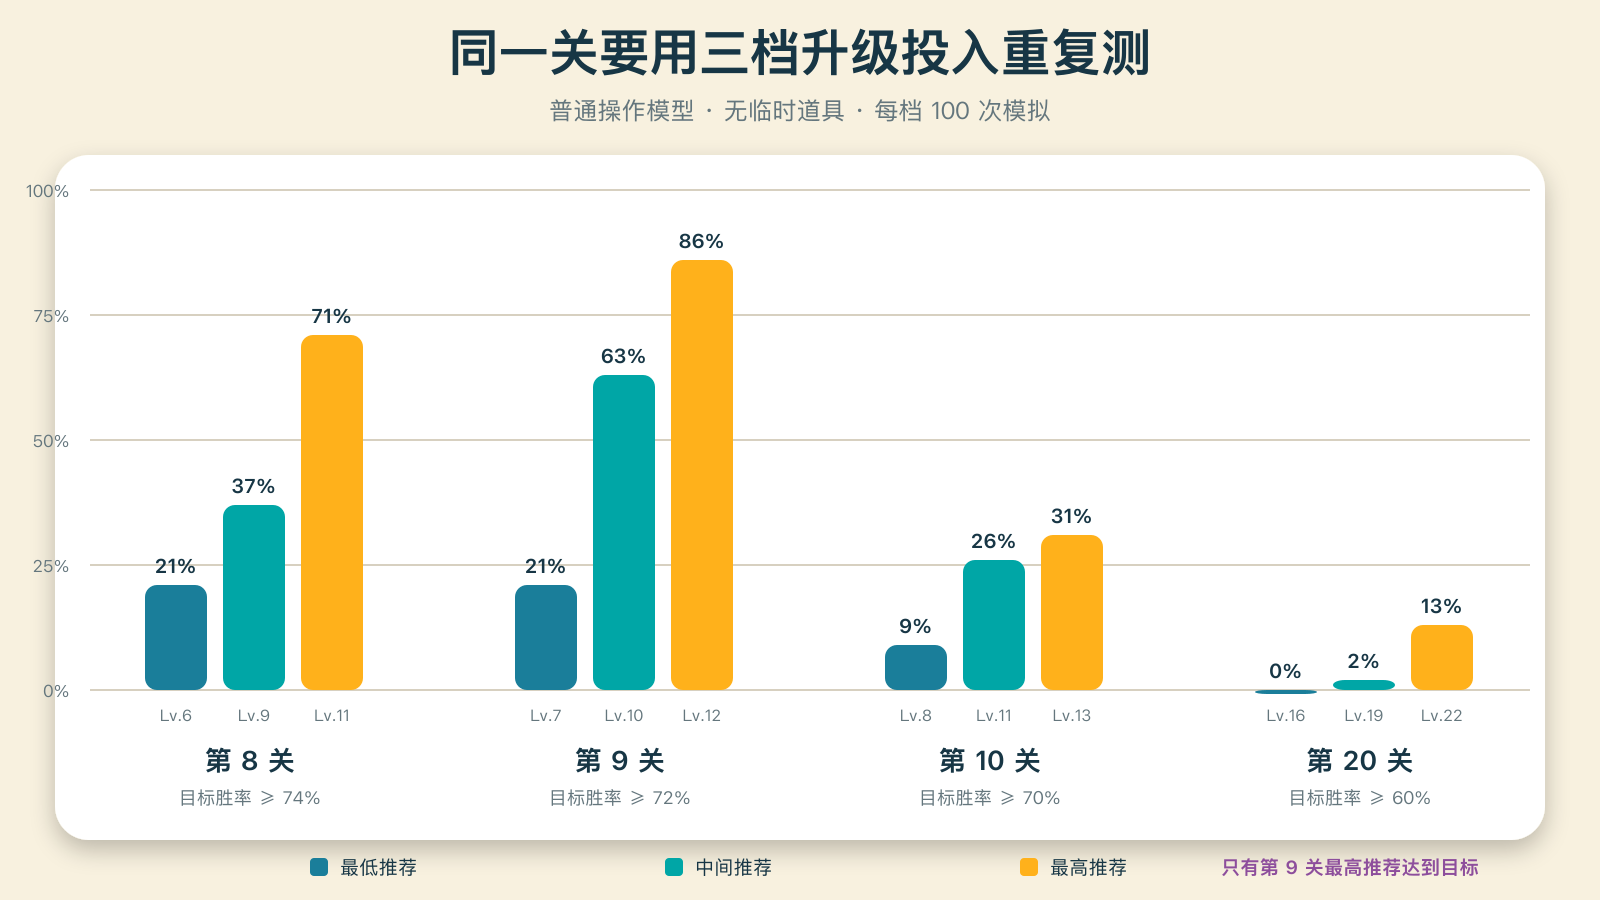
但第 10 关并没有出现同样结果:最低、中间和最高推荐的胜率分别为 9%、26% 和 31%,最高推荐下的胜利中位时长仍是 289.4 秒。第 20 关最高推荐也只有 13%。这说明问题不能只归因于资源不足,还需要检查 Boss、时间轴、操作模型和压力目标之间的组合。
更高等级也不是必然让每个指标单调变好。不同随机样本会改变出兵与交战节奏,所以判断要同时看胜率、时长、失败原因和置信范围,而不是只比较某两个数字的大小。
“最终能过”不是合格结论
单关模拟之后,还要把关卡连起来。当前使用普通操作模型、不使用临时道具、不领取广告奖励,从第 1 关连续推进到第 20 关。30 条模拟路径最终都能完成第 20 关,但平均累计失败 75.77 次,最长连续失败达到 41 次,平均需要 17.3 个自然日,其中 8.6 天在等待资源。
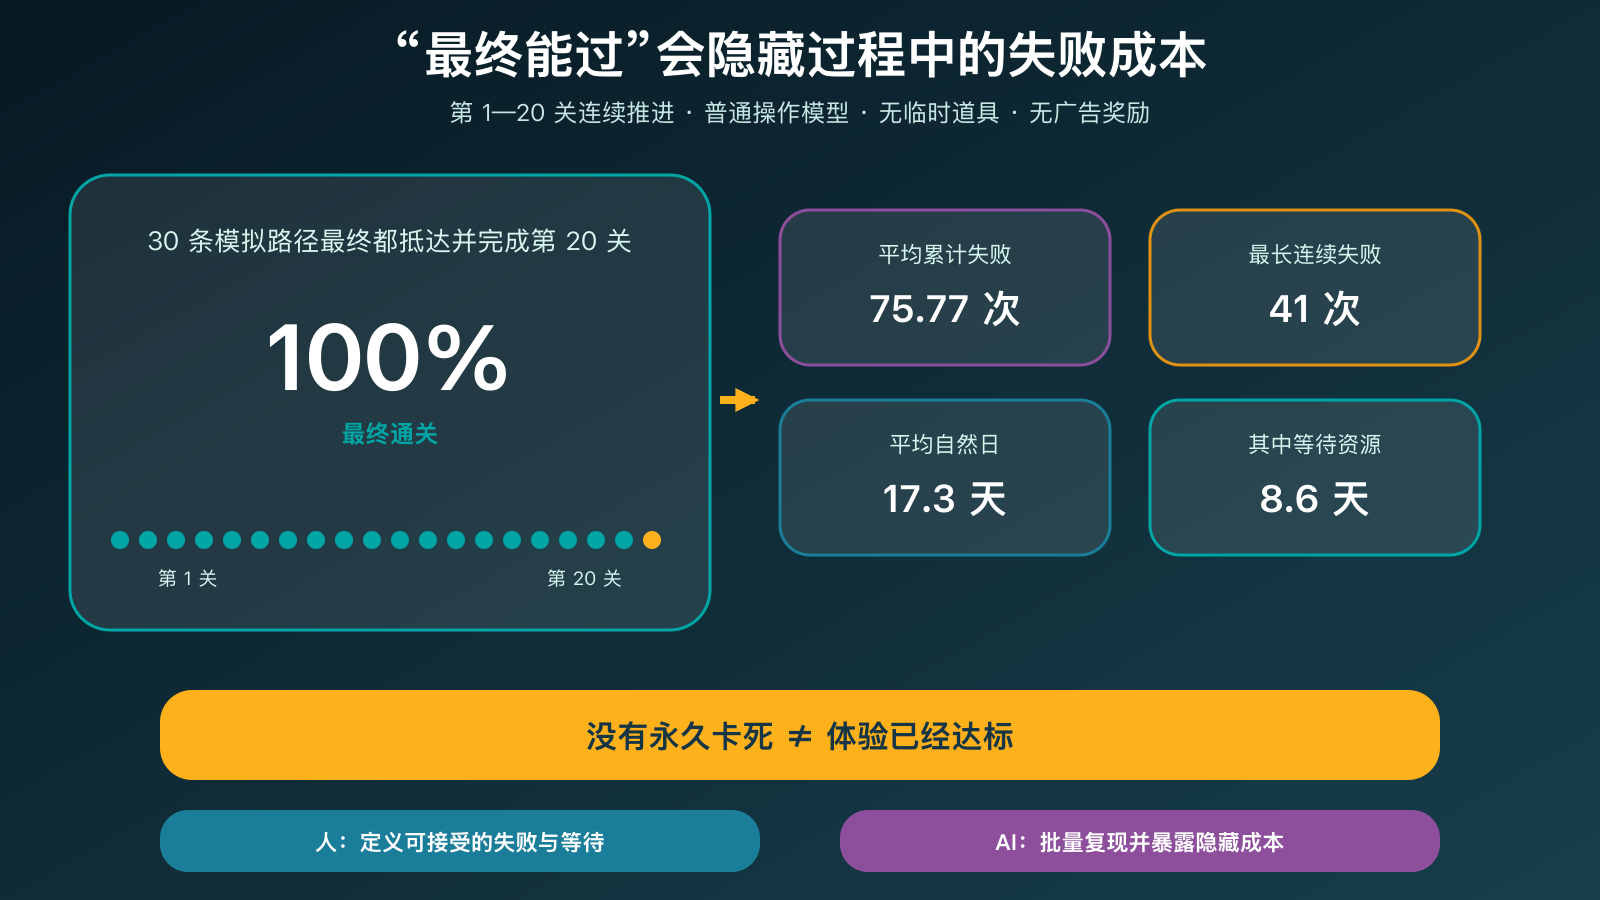
如果验收只记录“最终通关率 100%”,这条曲线看起来完全正常;加入累计失败、最长连败和等待天数后,结论立即改变。当前结果只能说明没有永久卡死,不能说明无道具主线已经达到预期体验。
这些数字是模型结果,不是真实玩家数据,也不能推导留存、付费或口碑。它们负责在上线前暴露风险;上线后的判断仍要依靠真实行为数据。静态检查能够证明公式、配置和引用关系一致,同样不能代替体验指标。
这个环节由谁负责
人负责定义目标:哪些关卡是教学、压力检查或阶段门槛,允许的首次胜率、战斗时长和连续失败是多少,正式基线是否排除临时道具和广告。人也负责决定哪些结果属于挑战,哪些已经变成消耗。
AI 负责读取同一套运行配置,批量执行不同升级等级和操作模型,汇总胜率、时长、失败原因、资源收入与累计支出,并在调整后重复检查普通敌人属性是否倒退、相邻关卡是否出现新断崖。
当前结论并不是“数值已经调完”,而是经济公式的静态合同有效,无道具主线仍有明确未达标位置。下一次调整必须针对压力或时间轴的原因进行,再用同一组指标复测,不能用运行时钳制或隐藏修正把异常压平。
如果你想开始
先为前十关各写下三个目标:期望胜率、期望时长和进入关卡前的推荐升级等级。选定一个不使用临时道具的基础操作模型,每关运行 100 次,至少记录胜率、胜利中位时长、失败原因和玩家基地剩余生命。
发现断崖后一次只改一个来源:奖励、升级成本、压力锚点或时间轴。修改后重新跑相邻三关,而不是只验证被修改的那一关。数据不能替你决定什么才有趣,但能阻止一次顺利试玩被误认为完整结论。